مشکل N+1 در جنگو چیست؟ آموزش select_related و prefetch_related
مشکل N+1 در جنگو چیست؟ آموزش select_related و prefetch_related #
آیا تا به حال پیش آمده که یک صفحه در پروژه Django روی دیتابیس محلی سریع اجرا شود، اما وقتی تعداد رکوردها افزایش پیدا میکند، سرعت آن به شکل محسوسی کاهش پیدا کند؟
یکی از دلایل احتمالی این مشکل، N+1 Query Problem یا مشکل N+1 در کوئریهای دیتابیس است.
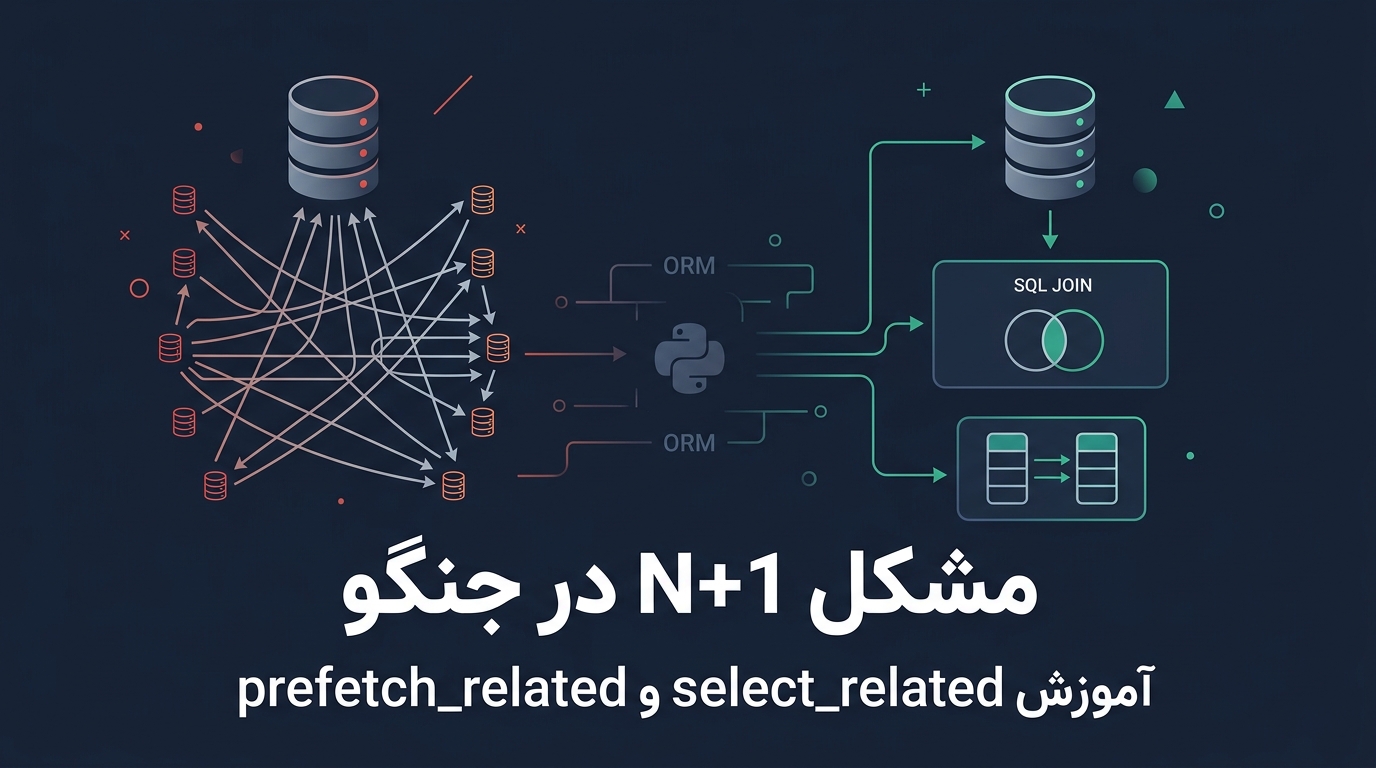
این مشکل معمولاً زمانی رخ میدهد که برنامه ابتدا تعدادی رکورد را از دیتابیس دریافت میکند و سپس برای دسترسی به اطلاعات مرتبط با هر رکورد، یک Query جداگانه اجرا میکند.
خبر خوب این است که Django ابزارهایی برای جلوگیری از این وضعیت دارد. در این آموزش، با مثالهای عملی یاد میگیریم مشکل N+1 چیست، چگونه آن را شناسایی کنیم و چطور با استفاده از select_related() و prefetch_related() تعداد درخواستهای دیتابیس را کاهش دهیم.
مشکل N+1 در Django چیست؟ #
فرض کنید در حال توسعه یک وبلاگ با جنگو هستید. هر مقاله یک نویسنده دارد و میخواهید فهرستی از مقالات را همراه با نام نویسندگان آنها نمایش دهید.
در چنین شرایطی، ممکن است کدی مانند زیر بنویسید:
posts = Post.objects.all()

for post in posts:
    print(post.title, post.author.name)
این کد ساده به نظر میرسد، اما میتواند مشکل عملکردی ایجاد کند.
ابتدا جنگو تمام مقالات موردنیاز را با یک Query دریافت میکند. سپس هنگام دسترسی به post.author.name، اگر اطلاعات نویسنده از قبل بارگذاری نشده باشد، ممکن است یک Query جداگانه برای دریافت نویسنده اجرا شود.
اگر تعداد مقالات برابر با ۱۰۰ باشد، الگوی اجرای Queryها ممکن است چنین باشد:
- یک Query برای دریافت مقالات
- صد Query برای دریافت نویسندگان
در نتیجه، مجموعاً ۱۰۱ Query اجرا میشود.
این همان مشکل N+1 است: یک Query اولیه بهعلاوه N Query اضافی برای اطلاعات مرتبط.
نکته: تعداد Queryها در مثالهای واقعی به نوع رابطه، کش ORM و نحوه دسترسی به دادهها بستگی دارد. عدد ۱۰۱ برای نشاندادن الگوی رایج این مشکل است، نه یک قانون همیشگی.
چرا مشکل N+1 باعث کندشدن پروژه میشود؟ #
هر Query دیتابیس علاوه بر اجرای عملیات در خود دیتابیس، هزینههایی مانند ارتباط با دیتابیس، انتقال نتیجه و پردازش دادهها را نیز دارد.
وقتی تعداد Queryها بیدلیل افزایش پیدا میکند، هزینه کلی اجرای درخواست نیز ممکن است بالا برود.
این مشکل در موقعیتهای زیر اهمیت بیشتری پیدا میکند:
- صفحههایی که تعداد زیادی رکورد نمایش میدهند.
- APIهایی که اطلاعات مرتبط با هر رکورد را در خروجی قرار میدهند.
- پروژههایی با تعداد کاربران یا درخواستهای همزمان زیاد.
- صفحاتی که از روابط پیچیده بین مدلهای Django استفاده میکنند.
برای مثال، ممکن است یک API در محیط توسعه با پنج مقاله سریع باشد، اما با دریافت صدها مقاله به تعداد زیادی Query اضافی نیاز پیدا کند.
البته کندی برنامه همیشه به دلیل N+1 نیست. قبل از بهینهسازی باید Queryهای واقعی و زمان اجرای آنها را بررسی کرد.
آموزش حل مشکل N+1 با select_related در Django #
اولین راهحل، استفاده از متد select_related() است.
این متد به Django ORM اجازه میدهد اطلاعات مدلهای مرتبط را از طریق JOIN در همان Query دریافت کند. این روش برای روابط تکمقداری مانند ForeignKey و OneToOneField مناسب است.
مرحله اول: بررسی مدلها #
فرض کنید دو مدل زیر را در فایل models.py دارید:
from django.db import models


class Author(models.Model):
    name = models.CharField(max_length=100)


class Post(models.Model):
    title = models.CharField(max_length=200)

    author = models.ForeignKey(
        Author,
        on_delete=models.CASCADE,
        related_name="posts",
    )
هر مقاله به یک نویسنده مرتبط است. بنابراین، هنگام دریافت مقالاتی که نام نویسنده آنها نیز لازم است، میتوانیم از select_related() استفاده کنیم.
مرحله دوم: بهینهسازی Query #
کد اولیه را به شکل زیر تغییر دهید:
posts = Post.objects.select_related("author")

for post in posts:
    print(post.title, post.author.name)
در این حالت، Django اطلاعات مقالات و نویسندگان مرتبط را با یک Query دارای JOIN دریافت میکند.
بنابراین، هنگام دسترسی به post.author.name دیگر نیازی به اجرای یک Query جداگانه برای هر نویسنده نیست.
در مثال ساده ما، تعداد Queryها از ۱۰۱ به یک Query کاهش پیدا میکند.
چه زمانی از select_related استفاده کنیم؟ #
از این متد زمانی استفاده کنید که به اطلاعات یک رابطه تکمقداری نیاز دارید؛ مانند:
- دریافت نویسنده هر مقاله با
ForeignKey - دریافت پروفایل مرتبط با یک کاربر با
OneToOneField - دریافت مشتری مرتبط با سفارش
- دریافت کاربر مرتبط با یک تیکت پشتیبانی
همچنین میتوانید روابط تو در تو را مشخص کنید:
posts = Post.objects.select_related(
    "author",
    "author__user_profile",
)
در این مثال، فرض شده است که رابطه user_profile از مسیر author در دسترس است. نام رابطه باید با مدلهای واقعی پروژه مطابقت داشته باشد.
آموزش حل مشکل N+1 با prefetch_related در Django #
روش دوم، استفاده از prefetch_related() است.
تفاوت مهم این متد با select_related() در نحوه دریافت دادهها است. متد prefetch_related() معمولاً اطلاعات مرتبط را در Queryهای جداگانه و گروهی دریافت میکند و سپس نتایج را در پایتون به نمونههای مدل متصل میکند.
این روش برای روابط چندمقداری مانند ManyToManyField و روابط معکوس ForeignKey کاربرد دارد.
مثال عملی: دریافت مقالات و نظرات #
فرض کنید هر مقاله میتواند چندین نظر داشته باشد.
مدل Comment را به این صورت تعریف میکنیم:
class Comment(models.Model):
    post = models.ForeignKey(
        Post,
        on_delete=models.CASCADE,
        related_name="comments",
    )

    text = models.TextField()
اکنون میخواهیم عنوان هر مقاله و تمام نظرات آن را نمایش دهیم.
کد زیر ممکن است باعث ایجاد مشکل N+1 شود:
posts = Post.objects.all()

for post in posts:
    print(post.title)

    for comment in post.comments.all():
        print(comment.text)
ابتدا مقالات دریافت میشوند و سپس برای هر مقاله، نظرات آن جداگانه بارگذاری میشوند.
اگر ۱۰۰ مقاله داشته باشیم، ممکن است یک Query برای مقالات و ۱۰۰ Query دیگر برای نظرات اجرا شود.
راهحل با prefetch_related #
کافی است QuerySet را به شکل زیر تغییر دهیم:
posts = Post.objects.prefetch_related("comments")

for post in posts:
    print(post.title)

    for comment in post.comments.all():
        print(comment.text)
در این حالت، Django معمولاً دو Query اجرا میکند:
- یک Query برای دریافت مقالات
- یک Query برای دریافت نظرات مرتبط با آن مقالات
سپس ارتباط بین مقالات و نظرات در پایتون برقرار میشود.
در مثال ساده بالا، تعداد Queryها از ۱۰۱ به ۲ کاهش پیدا میکند.
چه زمانی از prefetch_related استفاده کنیم؟ #
این متد برای موقعیتهایی مانند موارد زیر مناسب است:
- دریافت نظرات هر مقاله
- دریافت محصولات مرتبط با هر دستهبندی از طریق رابطه چندبهچند
- دریافت سفارشهای یک کاربر از مسیر رابطه معکوس
- نمایش فهرستهایی که برای هر رکورد به چندین رکورد مرتبط نیاز دارند
توجه کنید که اگر پس از Prefetch از Query جدیدی مانند post.comments.filter(...) استفاده کنید، ممکن است Query دیگری اجرا شود؛ زیرا فیلتر جدید لزوماً از نتایج از پیش بارگذاریشده استفاده نمیکند.
تفاوت select_related و prefetch_related در جنگو #
هر دو متد برای کاهش Queryهای اضافی کاربرد دارند، اما یکسان نیستند.
| ویژگی | select_related() |
prefetch_related() |
|---|---|---|
| روش اجرا | استفاده از SQL JOIN | دریافت گروهی دادههای مرتبط و اتصال در پایتون |
| روابط مناسب | ForeignKey و OneToOneField |
روابط چندمقداری و سایر روابط پشتیبانیشده |
| تعداد Query | معمولاً یک Query برای رابطه انتخابشده | معمولاً یک Query اصلی و یک Query اضافی برای هر رابطه Prefetchشده |
| مثال | مقاله و نویسنده | مقاله و نظرات آن |
یک قانون ساده برای شروع:
برای روابط تکمقداری از select_related() و برای روابط چندمقداری از prefetch_related() استفاده کنید.
البته این تصمیم باید بر اساس مدلها و دادههایی باشد که واقعاً نیاز دارید. بارگذاری بیشازحد اطلاعات مرتبط هم میتواند منابع بیشتری مصرف کند.
حل مشکل N+1 در Django REST Framework #
این مشکل فقط در Viewهای معمولی جنگو اتفاق نمیافتد. در پروژههای مبتنی بر Django REST Framework نیز ممکن است Serializer هنگام دسترسی به روابط مدل، Queryهای اضافی ایجاد کند.
برای مثال:
from rest_framework import serializers


class PostSerializer(serializers.ModelSerializer):
    author_name = serializers.CharField(
        source="author.name",
        read_only=True,
    )

    class Meta:
        model = Post
        fields = ["id", "title", "author_name"]
Serializer بالا به نام نویسنده هر مقاله نیاز دارد. اگر View دادهها را بدون بهینهسازی دریافت کند، ممکن است مشکل N+1 رخ دهد.
راهحل میتواند بهینهسازی QuerySet در View باشد:
from rest_framework.generics import ListAPIView

from .models import Post
from .serializers import PostSerializer


class PostListAPIView(ListAPIView):
    serializer_class = PostSerializer

    def get_queryset(self):
        return Post.objects.select_related("author")
در این مثال، اطلاعات نویسنده همراه مقالهها دریافت میشوند و Serializer برای دسترسی به نام نویسنده نیاز به Query جداگانه ندارد.
اگر Serializer به مجموعهای از روابط چندمقداری نیز نیاز داشته باشد، باید prefetch_related() را هم متناسب با نیاز اضافه کنید.
نکته: بهینهسازی QuerySet باید با توجه به فیلدهای واقعاً استفادهشده در Serializer و روابط مدلها انجام شود؛ افزودن همه روابط بهصورت غیرضروری راهحل مناسبی نیست.
چگونه مشکل N+1 را در پروژه Django پیدا کنیم؟ #
قبل از تغییر کد، باید مطمئن شوید که واقعاً با مشکل N+1 روبهرو هستید.
۱. استفاده از Django Debug Toolbar #
ابزار Django Debug Toolbar اطلاعات مفیدی درباره درخواستهای اجراشده، Queryهای SQL و زمان اجرای آنها ارائه میدهد.
اگر در یک صفحه تعداد زیادی Query مشابه برای دریافت دادههای مرتبط مشاهده کردید، بررسی مشکل N+1 ارزش دارد.
مستندات و اطلاعات این ابزار را میتوانید در وبسایت Django Debug Toolbar پیدا کنید.
۲. بررسی Queryهای دیتابیس #
در زمان توسعه میتوانید Queryهای اجراشده را از طریق ابزارهای بررسی SQL یا لاگگیری مناسب مشاهده کنید.
به دنبال الگویی بگردید که در آن Query مشابه بارها با شناسههای متفاوت اجرا میشود.
برای بررسی عمیقتر اجرای یک QuerySet، متد explain() جنگو نیز میتواند اطلاعاتی درباره برنامه اجرای Query ارائه دهد.
۳. نوشتن تست برای تعداد Queryها #
میتوانید با امکانات تست جنگو تعداد Queryها را بررسی کنید.
برای مثال، فرض کنید میخواهید مطمئن شوید بارگذاری مقالات و نظرات در یک حالت ساده با دو Query انجام میشود:
from django.test import TestCase

from .models import Post


class PostQueryTests(TestCase):
    def test_prefetch_comments(self):
        with self.assertNumQueries(2):
            posts = list(
                Post.objects.prefetch_related("comments")
            )
این تست باید در شرایطی اجرا شود که جدولهای موردنیاز در دسترس باشند و Queryهای پنهان دیگری به عملیات اضافه نشوند.
همچنین بهتر است دادههای آزمایشی داشته باشید تا رفتار واقعی رابطه را آزمایش کنید. تعداد دقیق Queryها در تست باید بر اساس عملیات مورد بررسی و ساختار واقعی پروژه تعیین شود.
اشتباهات رایج هنگام بهینهسازی Queryهای Django #
اشتباه اول: استفاده اشتباه از select_related #
این متد برای بارگذاری معمول یک مجموعه چندمقداری مانند تمام نظرات هر مقاله مناسب نیست. برای چنین رابطهای معمولاً باید prefetch_related() را بررسی کنید.
اشتباه دوم: اضافهکردن روابط بدون نیاز #
هرچه اطلاعات بیشتری دریافت کنید، ممکن است حجم نتایج، مصرف حافظه و پیچیدگی Query افزایش پیدا کند.
فقط روابطی را بارگذاری کنید که کد یا Serializer واقعاً به آنها نیاز دارد.
اشتباه سوم: تصور اینکه تمام مشکلات سرعت به N+1 مربوط هستند #
گاهی یک Query واحد بسیار سنگین است یا به دلیل ایندکسهای نامناسب، حجم زیاد دادهها یا عملیات پیچیده کند اجرا میشود.
در چنین شرایطی، کاهش تعداد Queryها لزوماً مشکل اصلی را حل نمیکند.
اشتباه چهارم: نادیدهگرفتن Pagination #
حتی اگر Queryها بهینه باشند، بارگذاری هزاران رکورد به شکل یکجا میتواند حافظه و زمان پاسخگویی را تحت فشار قرار دهد.
در صفحات فهرست و APIها، Pagination و محدودکردن دادههای موردنیاز را نیز در نظر بگیرید.
جمعبندی #
مشکل N+1 یکی از الگوهای رایج و مهم در بهینهسازی پروژههای Django است. این مشکل زمانی رخ میدهد که برنامه برای دسترسی به اطلاعات مرتبط با هر رکورد، Queryهای تکراری اجرا میکند.
برای شروع، دو ابزار اصلی را به خاطر بسپارید:
select_related()برای دریافت روابط تکمقداری از طریق SQL JOINprefetch_related()برای دریافت گروهی روابط چندمقداری و اتصال نتایج در پایتون
این متدها میتوانند تعداد Queryها را بهطور چشمگیری کاهش دهند، اما بهتر است ابتدا عملکرد برنامه را اندازهگیری کنید و سپس بهینهسازی را بر اساس شواهد انجام دهید.
اگر با Django REST Framework کار میکنید، QuerySetهای مورد استفاده در Viewها و Serializerها را نیز بررسی کنید؛ گاهی بخش مهمی از مشکل N+1 دقیقاً در همین مسیر به وجود میآید.