Jev AI چیست؟ بررسی فنی مدلهای تصمیمگیری هوش مصنوعی
Jev AI چیست؟ بررسی فنی مدلهای تصمیمگیری هوش مصنوعی #
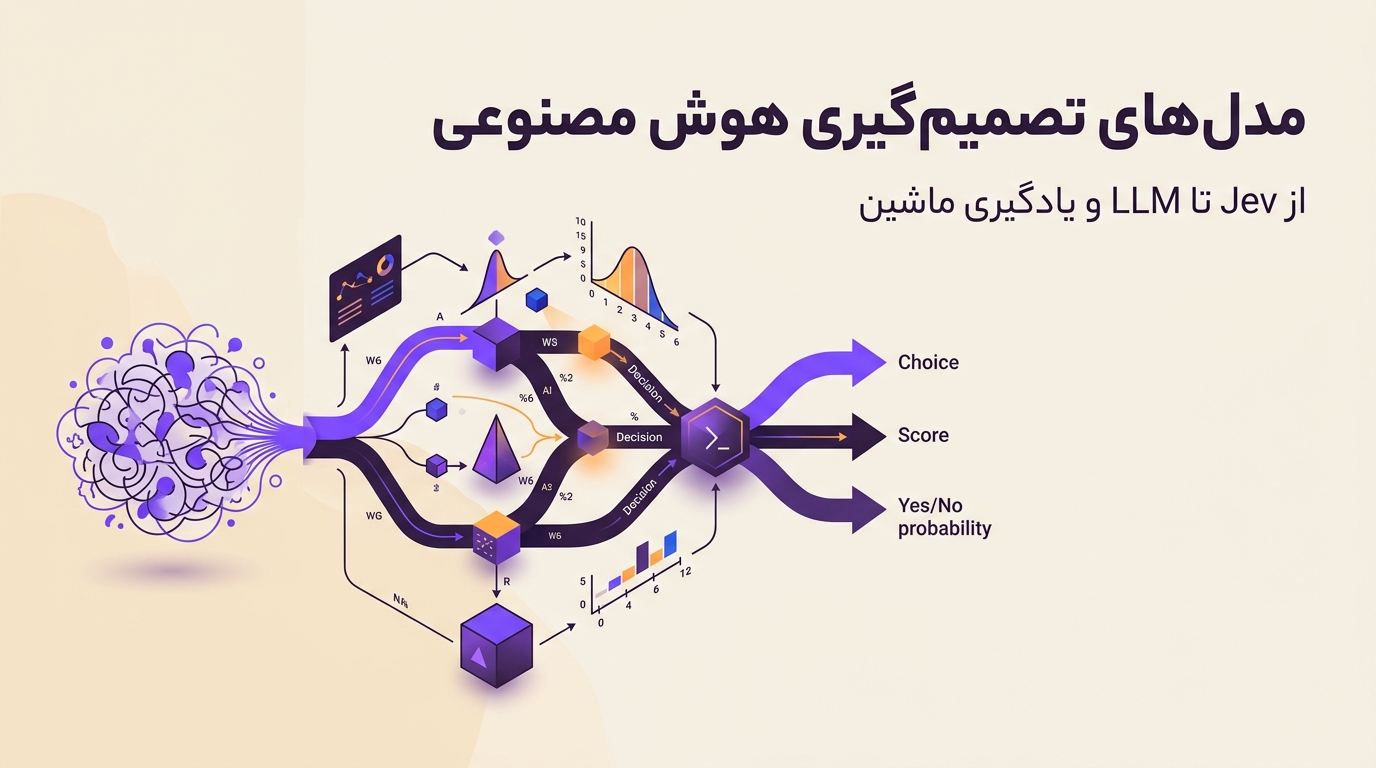
در بسیاری از نرمافزارهای امروزی، مسئله اصلی تولید متن نیست؛ بلکه انتخاب یک تصمیم مناسب بر اساس اطلاعات موجود است.
برای مثال، یک سیستم پشتیبانی باید تشخیص دهد که یک تیکت به کدام تیم ارجاع داده شود. یک سامانه امنیتی باید بررسی کند که آیا یک درخواست مشکوک است یا خیر. یک AI Agent نیز باید بتواند تصمیم بگیرد که ابزار موردنیاز خود را اجرا کند یا برای بررسی بیشتر از کاربر کمک بخواهد.
برای حل این مسائل، توسعهدهندگان معمولاً از ترکیبی از قوانین برنامهنویسی، مدلهای یادگیری ماشین و مدلهای زبانی بزرگ یا LLMها استفاده میکنند.
اما آیا لازم است برای هر تصمیم کوچک، یک مدل زبانی بزرگ را اجرا کنیم؟
Jev AI با همین پرسش وارد بحث شده است. این مدل که توسط TypeSafe AI معرفی شده، برای پاسخدادن به پرسشهای محدود و ساختاریافته طراحی شده است؛ یعنی بهجای تولید یک پاراگراف، خروجیای ارائه میکند که نرمافزار بتواند مستقیماً از آن استفاده کند. منبع معرفی Jev توسط سازنده
در این مقاله، از دید مهندسی نرمافزار و یادگیری ماشین بررسی میکنیم که Jev چگونه کار میکند، چه تفاوتی با مدلهای کلاسیک تصمیمگیری دارد و در چه شرایطی استفاده از آن منطقی است.
۱. مدل تصمیمگیری هوش مصنوعی چیست؟ #
اصطلاح Decision Model یا مدل تصمیمگیری هوش مصنوعی بهتنهایی نام یک الگوریتم مشخص نیست. این اصطلاح میتواند به روشها و مدلهای مختلفی اشاره داشته باشد که اطلاعات ورودی را به یک انتخاب، امتیاز، احتمال یا اقدام پیشنهادی تبدیل میکنند.
فرض کنید یک API درخواست زیر را دریافت میکند:
{
    "message": "My payment was deducted twice.",
    "customer_type": "premium",
    "days_waiting": 4
}
سیستم باید درباره این درخواست چند تصمیم بگیرد:
- موضوع درخواست چیست؟
- اولویت رسیدگی چقدر است؟
- آیا دخالت کارشناس انسانی ضروری است؟
- درخواست باید به کدام تیم ارسال شود؟
این تصمیمها را میتوان با روشهای متفاوتی گرفت.
یک سیستم Rule-Based میتواند از شرطهای از پیش تعریفشده استفاده کند. یک مدل طبقهبندی میتواند از دادههای آموزشی الگو یاد بگیرد. یک LLM میتواند متن درخواست را تحلیل کند و خروجی ساختاریافته تولید کند. یک مدل تخصصی تصمیمگیری مانند Jev نیز برای انتخابها و ارزیابیهای محدود طراحی شده است.
تفاوت اصلی این روشها در نحوه یادگیری، نوع ورودی و خروجی، هزینه اجرا، قابلیت تفسیر و میزان اطمینانپذیری آنها است.
۲. Jev AI چگونه کار میکند؟ #
Jev از دستهای است که TypeSafe AI آن را System One Models مینامد. هدف این دسته از مدلها انجام قضاوتهای محدود و سریع درون نرمافزار است، نه مکالمه آزاد با کاربر.
در رابط این مدل، دو مفهوم اصلی وجود دارد:
State: اطلاعاتی که مدل باید بررسی کند؛ برای مثال متن یک تیکت، رویداد ثبتشده در سیستم یا اطلاعات ساختاریافته یک درخواست.
Questions: پرسشهای مشخصی که پاسخ آنها در قالبهای تعریفشده قرار میگیرد.
در نتیجه، بهجای اینکه از مدل بخواهیم یک پاسخ طولانی تولید کند و سپس آن را به مقادیر قابل استفاده تبدیل کنیم، از ابتدا نوع خروجی موردنیاز را مشخص میکنیم.
طبق مستندات منتشرشده، Jev سه نوع پرسش اصلی دارد:
| نوع پرسش | کاربرد فنی | نوع خروجی |
|---|---|---|
Choice |
انتخاب میان گزینههای تعریفشده | گزینه منتخب و توزیع احتمال گزینهها |
Score |
قرار دادن ورودی روی یک مقیاس ترتیبی | امتیاز و اطلاعات احتمالاتی مربوط به سطحها |
Noul |
ارزیابی یک پرسش دوحالته | احتمال یک گزاره، با مقدار بین صفر و یک |
این پرسشها میتوانند در یک درخواست ترکیب شوند و مدل آنها را بر اساس یک State مشترک ارزیابی کند. مستندات رسمی API
یک مثال ساده از خروجی مورد انتظار #
فرض کنید تیکت زیر را دریافت کردهایم:
The customer was charged twice and has waited
four days for a response.
در این مثال، برنامه میتواند سه پرسش تعریف کند:
{
    "queue": {
        "type": "choice",
        "criteria": {
            "billing": "Payments, invoices, and refunds",
            "technical": "API errors and technical issues",
            "sales": "Questions about purchasing plans"
        },
        "instructions": "Choose the correct support team."
    },
    "urgency": {
        "type": "score",
        "criteria": [
            "Low",
            "Normal",
            "High",
            "Critical"
        ],
        "instructions": "Rate the urgency of the ticket."
    },
    "needs_human": {
        "type": "noul",
        "instructions": "Does this case require human review?"
    }
}
در این درخواست، state باید جداگانه همراه مجموعه questions ارسال شود؛ قطعه کد بالا فقط تعریف پرسشها را نشان میدهد.
خروجی مورد انتظار از نظر مفهومی میتواند شامل انتخاب تیم مالی، امتیاز فوریت و احتمال نیاز به بررسی انسانی باشد. این مثال توضیحی است و خروجی واقعی اجرای مدل نیست.
نکته مهم این است که Jev قرار نیست خودش الزاماً عملیات تجاری را اجرا کند. اگر نتیجه انتخاب تیم مالی باشد، همچنان کد برنامه مسئول ارجاع تیکت است.
۳. تفاوت Jev با مدلهای زبانی بزرگ (LLM) #
مدلهای زبانی بزرگی مانند GPT و Claude برای درک و تولید زبان طبیعی طراحی شدهاند. آنها میتوانند استدلال، کدنویسی، توضیحدادن و تولید متن را در طیف وسیعی از وظایف انجام دهند.
در مقابل، Jev بر خروجیهای محدود و قابل استفاده برای ماشین تمرکز دارد.
برای مقایسه، دو رویکرد را تصور کنید.
رویکرد اول: استفاده از LLM #
از مدل زبانی میخواهیم درخواست کاربر را طبقهبندی کند و JSON برگرداند.
مدل باید ورودی را پردازش کند، پاسخ تولید کند و خروجی در قالب مورد انتظار باقی بماند. اگر خروجی معتبر نباشد یا فیلدهای لازم را نداشته باشد، برنامه ممکن است به اعتبارسنجی یا تلاش مجدد نیاز پیدا کند.
البته LLMها میتوانند از قابلیتهای Structured Outputs یا روشهای معادل برای محدودکردن شکل خروجی استفاده کنند؛ بنابراین JSON الزاماً به معنی خروجی غیرقابل اعتماد نیست.
رویکرد دوم: استفاده از Jev #
در این رویکرد، نوع و ساختار پاسخ از ابتدا مشخص است. برنامه درخواست میکند که یک گزینه انتخاب شود، یک معیار امتیازدهی شود یا احتمال وقوع یک گزاره تخمین زده شود.
این طراحی میتواند بخشی از پردازش خروجی را سادهتر کند، چون دیگر لازم نیست یک پاراگراف تولیدشده به ساختار تصمیمگیری تبدیل شود.
بااینحال، ساختاریافتهبودن خروجی تضمین نمیکند که تصمیم معنایی مدل درست باشد. مدل همچنان ممکن است تیکت را اشتباه طبقهبندی کند.
| معیار | LLM عمومی | Jev |
|---|---|---|
| هدف اصلی | زبان، تولید متن و وظایف عمومی | تصمیمهای محدود و ساختاریافته |
| خروجی معمول | متن یا داده ساختاریافته | انتخاب، امتیاز یا احتمال تعریفشده |
| تولید متن آزاد | قابلیت اصلی | طبق توضیحات فعلی سازنده، هدف مدل نیست |
| کاربرد مناسب | توضیح، نگارش، تحلیل و استدلال | طبقهبندی، مسیریابی و امتیازدهی محدود |
| اقدام نهایی در نرمافزار | مسئولیت برنامه | مسئولیت برنامه |
بنابراین، مقایسه Jev با LLM لزوماً یک رقابت برای جایگزینکردن کامل یک مدل با مدل دیگر نیست. در بسیاری از سیستمها، این دو میتوانند مکمل یکدیگر باشند.
۴. مقایسه Jev با مدلهای کلاسیک یادگیری ماشین #
مدلهای تصمیمگیری فقط به LLMها محدود نیستند. بسیاری از مسائل واقعی را میتوان با الگوریتمهای یادگیری ماشین کلاسیک حل کرد.
درخت تصمیم (Decision Tree) #
درخت تصمیم با یادگیری قواعد شرطی از دادههای آموزشی، مسیرهای تصمیمگیری ایجاد میکند.
برای مثال، یک مدل میتواند از روی مبلغ تراکنش، تعداد تلاشهای ناموفق و سابقه حساب، ریسک یک تراکنش را تخمین بزند.
مزیت مهم درخت تصمیم، قابلیت مشاهده و بررسی مسیرهای تصمیمگیری آن است. بااینحال، دقت و تعمیمپذیری مدل به کیفیت دادهها و نحوه آموزش آن وابسته است.
رگرسیون لجستیک و مدلهای طبقهبندی #
رگرسیون لجستیک میتواند برای پیشبینی احتمال تعلق یک نمونه به یک کلاس استفاده شود. این مدل برای ویژگیهای ساختاریافته و مسائل طبقهبندی مشخص انتخاب مناسبی است.
برای نمونه، یک سیستم میتواند با دادههای تاریخی یاد بگیرد که کدام درخواستها احتمال بیشتری برای لغو سرویس دارند.
Random Forest و Gradient Boosting #
این روشها از چندین درخت تصمیم یا ترکیبی از مدلهای درختی استفاده میکنند و در مسائل دادههای جدولی کاربرد زیادی دارند.
در مسائل امتیازدهی ریسک، پیشبینی رفتار مشتری یا کشف الگوهای تراکنش، این مدلها ممکن است از یک مدل عمومی زبانی مناسبتر باشند؛ بهخصوص زمانی که داده آموزشی کافی و معیار ارزیابی مشخص وجود دارد.
مستندات رسمی scikit-learn توضیحاتی درباره درختهای تصمیم، رگرسیون لجستیک و روشهای Ensemble ارائه میکنند: راهنمای الگوریتمهای یادگیری ماشین.
تفاوت بنیادی با Jev #
مدلهای کلاسیک معمولاً با یک مجموعه داده و برچسب یا هدف مشخص آموزش داده میشوند. در زمان استقرار، ویژگیهای ورودی به مدل داده میشوند و پیشبینی دریافت میشود.
Jev بهعنوان یک سرویس تصمیمگیری، میتواند با یک State متنی یا ساختاریافته و پرسشهایی که توسعهدهنده تعریف میکند، کار کند. بنابراین، رابط استفاده از آن با API یک طبقهبند کلاسیک تفاوت دارد.
این تفاوت به معنای برتری همیشگی Jev نیست. اگر یک مدل ساده و ارزان با داده اختصاصی شما دقت کافی دارد، استفاده از یک سرویس تخصصی خارجی ممکن است ضرورت نداشته باشد.
۵. مقایسه Jev با سیستمهای Rule-Based #
قبل از استفاده از مدل هوش مصنوعی، باید بررسی کنیم که آیا مسئله اساساً به هوش مصنوعی نیاز دارد یا خیر.
یک سیستم Rule-Based مجموعهای از قواعد صریح برنامهنویسی است:
def choose_queue(message):
    message = message.lower()

    if "refund" in message or "charged twice" in message:
        return "billing"

    if "api error" in message:
        return "technical"

    return "general"
این کد ساده است و میتوانیم دقیقاً رفتار آن را بررسی کنیم. اما وقتی زبان کاربران متنوعتر شود، تعداد حالتها افزایش پیدا کند یا معنای پیامها پیچیده شود، نگهداری قواعد دشوارتر میشود.
یک مدل هوش مصنوعی میتواند در تشخیص معنایی انعطاف بیشتری داشته باشد؛ اما ممکن است خطا کند، هزینه پردازش داشته باشد و برای بررسی رفتار آن به آزمایش نیاز باشد.
به همین دلیل، در یک سیستم حرفهای معمولاً ترکیب قواعد و مدلهای یادگیری ماشین منطقیتر از حذف کامل یکی از آنها است.
برای مثال، قانون میتواند تعیین کند که یک تراکنش بالاتر از سقف مشخص حتماً نیازمند بررسی باشد، در حالی که مدل هوش مصنوعی برای طبقهبندی متن درخواست و پیشنهاد تیم مسئول به کار رود.
۶. آیا Reinforcement Learning هم یک مدل تصمیمگیری است؟ #
بله، یادگیری تقویتی (Reinforcement Learning) یکی از روشهای مهم ساخت سیستمهای تصمیمگیر است، اما با طبقهبندی ساده تفاوت دارد.
در یادگیری تقویتی، عامل با محیط تعامل میکند، اقدام انجام میدهد و بر اساس پاداش یا پیامدهای دریافتی، سیاست انتخاب اقدام را یاد میگیرد.
برای نمونه، یک عامل میتواند یاد بگیرد در یک محیط شبیهسازیشده چه زمانی منبع مصرف کند، چه مسیری انتخاب کند یا کدام اقدام را برای رسیدن به هدف انجام دهد.
در مقابل، طبقهبند معمولی ممکن است تنها تعیین کند که یک ورودی به کدام دسته تعلق دارد.
این دو رویکرد مسئلههای متفاوتی را هدف قرار میدهند:
- Classification: این ورودی متعلق به کدام دسته است؟
- Scoring: این نمونه چه امتیازی دارد؟
- Decision Policy: با توجه به وضعیت فعلی، کدام اقدام مناسبتر است؟
- Reinforcement Learning: چگونه سیاست اقدامکردن را از تعامل و بازخورد یاد بگیریم؟
TypeSafe AI روش آموزشی خود برای Jev را Reinforcement Learning for Calibrated Decisions یا RLCD معرفی کرده است. این نام و ادعا، توضیح سازنده درباره روش آموزش محصول است و بهتنهایی اثبات نمیکند که Jev معادل تمام عاملهای یادگیری تقویتی یا مناسب همه مسائل تصمیمگیری ترتیبی است. معرفی فنی سازنده
۷. احتمالات و Confidence در مدلهای تصمیمگیری چه اهمیتی دارند؟ #
یکی از بخشهای مهم مدلهای تصمیمگیری، نحوه نمایش عدم قطعیت است.
فرض کنید مدل برای یک تیکت، احتمال نیاز به بررسی انسانی را ۰٫۸۵ اعلام میکند. برنامه میتواند این نتیجه را با یک سیاست مشخص ترکیب کند:
if needs_human_probability >= 0.90:
    send_to_human_review()
elif needs_human_probability >= 0.60:
    add_manual_review_flag()
else:
    continue_automated_workflow()
در این مثال، آستانهها صرفاً نمونه هستند و باید بر اساس دادههای واقعی و هزینه خطا تنظیم شوند.
برای مثال، در یک سامانه امنیتی ممکن است هزینه نادیدهگرفتن یک مورد پرریسک بسیار بیشتر از هزینه ارسال یک مورد سالم برای بررسی باشد.
اما یک نکته فنی مهم وجود دارد: عدد احتمال زمانی واقعاً مفید است که کالیبره باشد.
اگر در میان پیشبینیهایی که احتمال ۰٫۸۰ دارند، فقط ۵۰ درصد موارد واقعاً مثبت باشند، این اعداد با فراوانی واقعی رخدادها بهخوبی تطابق ندارند.
بنابراین، نباید فقط به عددی که مدل بهعنوان Confidence یا Probability ارائه میکند اعتماد کنیم. باید آن را با دادههای ارزیابی مستقل بررسی کنیم، آستانهها را تنظیم کنیم و در صورت نیاز بازکالیبراسیون انجام دهیم.
ادعای کالیبرهبودن خروجیهای Jev از سوی سازنده مطرح شده است؛ میزان دقت و کالیبراسیون آن در کاربرد شما باید جداگانه سنجیده شود.
۸. طراحی معماری ترکیبی برای تصمیمگیری هوشمند #
یکی از کاربردهای جذاب این مدلها، استفاده از چند روش در کنار یکدیگر است.
فرض کنید در حال ساخت یک سامانه مدیریت تیکت هستیم. معماری پیشنهادی میتواند چنین باشد:
Incoming Ticket
       |
       v
Input Validation
       |
       v
Rule-Based Safety Checks
       |
       v
Decision Model
       |
       +------> Route to Team
       |
       +------> Calculate Priority
       |
       +------> Request Human Review
       |
       v
Application Workflow
       |
       v
LLM for User-Facing Explanation
در این معماری، هر جزء وظیفه مشخصی دارد:
اعتبارسنجی ورودی: ساختار داده را بررسی میکند و فیلدهای ضروری را کنترل میکند.
قواعد قطعی: قوانین سخت و غیرقابلتفسیر را اجرا میکنند.
مدل تصمیمگیری: وظایفی مانند طبقهبندی موضوع، امتیازدهی یا ارزیابی نیاز به بررسی را انجام میدهد.
کد برنامه: نتیجه را اعتبارسنجی میکند و اقدام مجاز را اجرا میکند.
LLM: در صورت نیاز، توضیح قابلفهم برای کاربر یا گزارش متنی تولید میکند.
مدل تصمیمگیری نباید صرفاً با بازگرداندن یک برچسب، اختیار اجرای هر اقدام حساسی را داشته باشد. برنامه همچنان باید مجوزها، محدودیتها و قواعد تجاری را بررسی کند.
برای مثال، خروجی یک مدل نباید بهتنهایی باعث پرداخت وجه، حذف اطلاعات مهم یا تغییر وضعیت حساس یک حساب شود؛ چنین اقداماتی باید تحت کنترل منطق کسبوکار و سیاستهای امنیتی باشند.
۹. چطور انتخاب کنیم: Jev، LLM یا مدل کلاسیک؟ #
برای تصمیمگیری درباره انتخاب مدل، ابتدا مسئله را دقیق تعریف کنید.
| نوع مسئله | گزینههایی که ارزش بررسی دارند |
|---|---|
| دستهبندی متن و مسیریابی تیکت | Jev، LLM، مدل طبقهبندی متن |
| پیشبینی ریسک با دادههای جدولی | رگرسیون لجستیک، Random Forest، Gradient Boosting |
| تصمیم بر اساس قوانین قطعی | Rule-Based |
| تولید پاسخ قابلفهم برای کاربر | LLM عمومی |
| انتخاب اقدام در محیط پویا با بازخورد | روشهای یادگیری تقویتی |
| ترکیب قضاوت معنایی و اجرای کنترلشده | معماری ترکیبی با مدل و قواعد |
هیچ گزینهای در همه شرایط بهترین نیست.
اگر مسئله ورودی ساختاریافته و برچسبهای مشخص دارد، ابتدا یک مدل کلاسیک ساده را بهعنوان خط مبنا آزمایش کنید. اگر تشخیص معنای زبان طبیعی دشوار است، یک LLM یا مدل تصمیمگیری تخصصی را ارزیابی کنید. اگر قواعد دقیق و غیرقابلتغییر دارید، اجرای مستقیم آنها قابلکنترلتر است.
در نهایت باید گزینهها را روی دادههای یکسان و بر اساس معیارهای مرتبط با مسئله مقایسه کرد.
۱۰. محدودیتها و نکات مهم در استفاده از Jev #
پیش از افزودن Jev به یک سامانه واقعی، چند موضوع را بررسی کنید.
۱. کیفیت داده ورودی: تصمیم یک مدل به اطلاعاتی وابسته است که در اختیار آن قرار میدهید. اگر وضعیت ناقص یا گمراهکننده باشد، خروجی نیز ممکن است اشتباه باشد.
۲. کیفیت تصمیم: خروجی ساختاریافته الزاماً خروجی درست نیست. اعتبارسنجی شکل داده و صحت معنایی تصمیم دو مسئله جداگانه هستند.
۳. هزینه و تأخیر واقعی: اعداد اعلامشده درباره سرعت یا هزینه باید در محیط واقعی شما اندازهگیری شوند. زمان شبکه، اندازه ورودی، محدودیت سرویس و زمان پردازش برنامه میتوانند بر نتیجه نهایی اثر بگذارند.
۴. تغییر نسخه: اگر نسخه مدل تغییر کند، رفتار آن نیز ممکن است تغییر کند. برای استقرار پایدار، نسخه را ثبت و نتایج را با مجموعه تست ثابت مقایسه کنید.
۵. محرمانگی: اگر State حاوی اطلاعات شخصی، مالی یا سازمانی است، شرایط پردازش داده، نگهداری اطلاعات و الزامات امنیتی سرویس را قبل از ارسال بررسی کنید.
۶. ارزیابی مستقل: روی مجموعه دادهای که هنگام آموزش یا تنظیم سیستم استفاده نشده است، معیارهایی مانند Precision، Recall، F1، کیفیت کالیبراسیون، نرخ ارجاع اشتباه و تأخیر را اندازهگیری کنید.
همچنین توجه کنید که جزئیات داخلی معماری Jev، مانند وزنهای مدل و تعداد پارامترها، از اطلاعات عمومی قابل استناد این مقاله بهطور کامل مشخص نیستند. بنابراین، مقایسه فنی باید بر رابط ورودی و خروجی، رفتار قابل مشاهده و نتایج آزمایشهای قابل تکرار استوار باشد؛ نه حدسزدن درباره معماری داخلی.
جمعبندی #
مدلهای تصمیمگیری هوش مصنوعی را نباید صرفاً نسخهای کوچکتر از چتباتها در نظر گرفت. در بسیاری از نرمافزارها، مسئله اصلی نه تولید پاسخ طولانی، بلکه انتخاب گزینه مناسب، امتیازدهی، تخمین احتمال و تعیین مسیر اجرای برنامه است.
Jev با تمرکز بر تصمیمهای ساختاریافته تلاش میکند این بخش را به یک رابط قابل استفاده برای نرمافزار تبدیل کند. در مقابل، مدلهای کلاسیک در مسائل دارای ویژگیها و برچسبهای مشخص میتوانند انتخاب مناسبتری باشند، LLMها برای تولید زبان و تحلیل عمومی انعطاف بیشتری دارند و سیستمهای Rule-Based نیز برای قوانین قطعی همچنان اهمیت دارند.
رویکرد مهندسی مناسب این نیست که یک مدل را برای همه مسائل انتخاب کنیم؛ بلکه باید هر تصمیم را به اجزای کوچکتر تقسیم کنیم، راهحلهای ساده را با راهحلهای هوشمند مقایسه کنیم و نتیجه را با داده واقعی بسنجیم.
در یک معماری مناسب، مدل پیشنهاد میدهد یا قضاوت میکند؛ اما نرمافزار مسئول کنترل، اعتبارسنجی و اجرای تصمیم باقی میماند.