سوگیری بقا در هوش مصنوعی؛ وقتی دادههای حذفشده نتیجه را تغییر میدهند
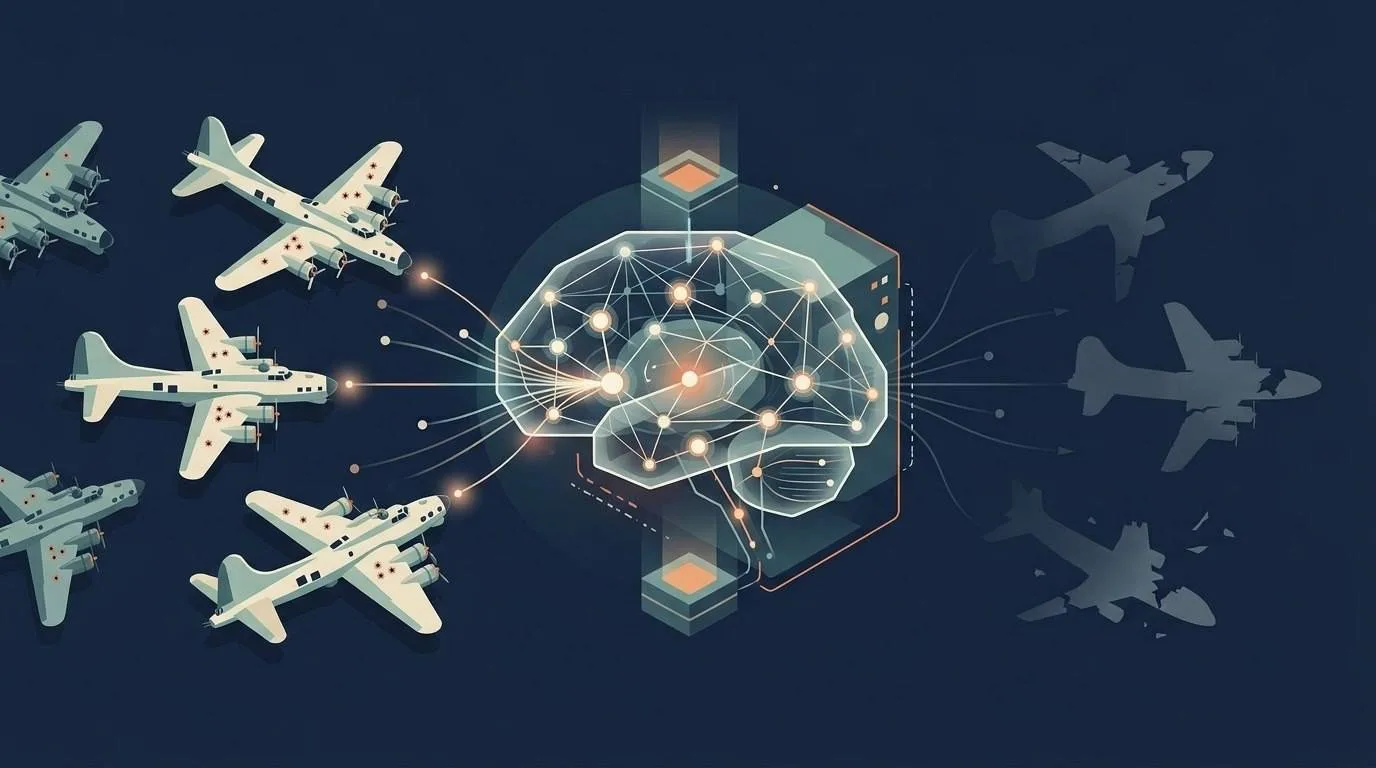
در آموزش و ارزیابی مدلهای هوش مصنوعی، معمولاً توجه زیادی به کیفیت دادهها، معماری مدل و معیارهای ارزیابی میشود. اما یک مشکل کمتر آشکار هم وجود دارد: دادههایی که اصلاً وارد مجموعهداده نمیشوند یا در مراحل اولیه کنار گذاشته میشوند. سوگیری بقا (Survivorship Bias) یکی از انواع سوگیری است که در چنین شرایطی میتواند تصویر ما از واقعیت را تغییر دهد.
در این مقاله، با مفهوم سوگیری بقا در هوش مصنوعی آشنا میشویم و 3 نمونه پژوهشی را بررسی میکنیم که نشان میدهند دادههای حذفشده، اطلاعات ناقص و خروجیهای سوگیرانه چگونه میتوانند بر نتیجهگیری سیستمهای هوشمند تأثیر بگذارند.
سوگیری بقا چیست؟ #
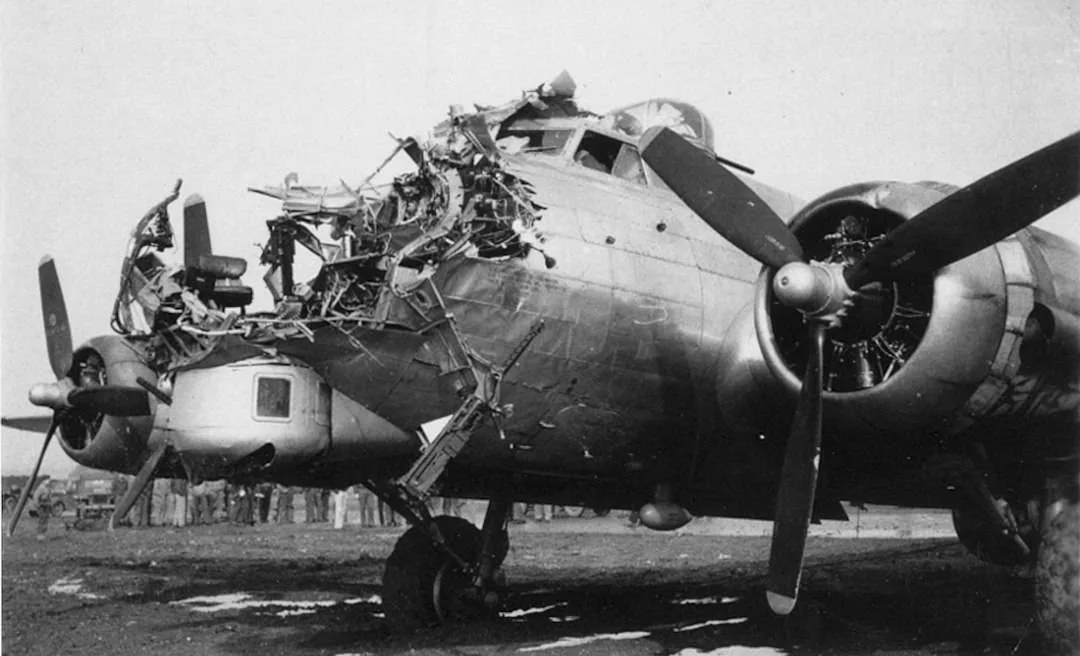
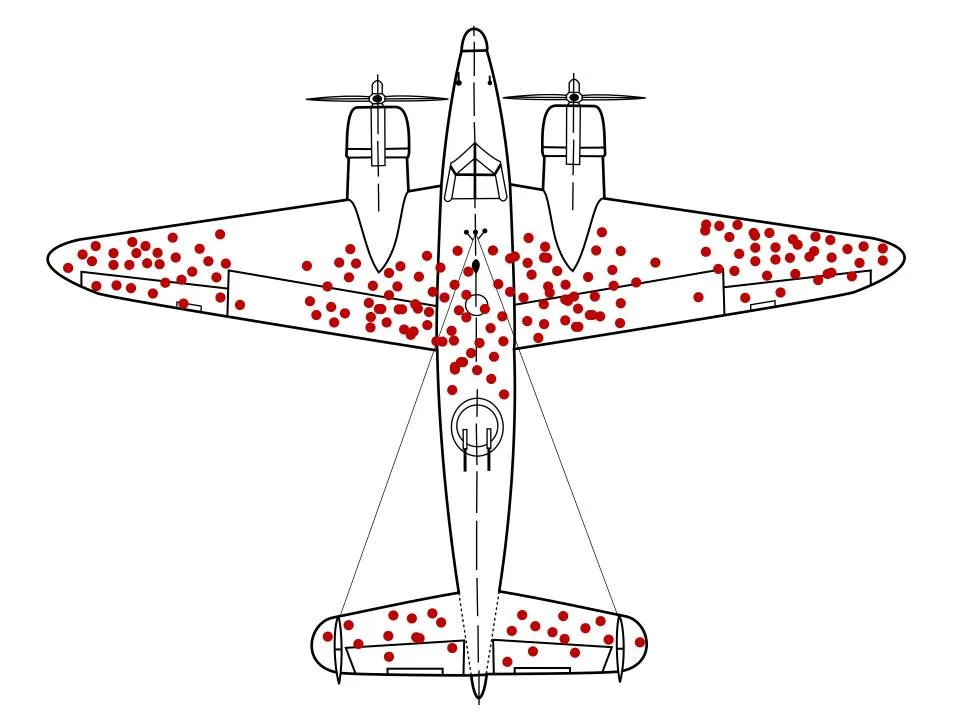
سوگیری بقا زمانی رخ میدهد که فقط موارد باقیمانده، موفق یا قابل مشاهده را بررسی کنیم و موارد حذفشده یا ناموفق را نادیده بگیریم. در این شرایط، نمونههایی که بررسی میکنیم لزوماً نماینده کل جامعه نیستند و نتیجهگیری ما ممکن است با واقعیت تفاوت داشته باشد.
یک مثال ساده را در نظر بگیرید. فرض کنید میخواهید بفهمید چه ویژگیهایی باعث موفقیت شرکتهای فناوری میشوند. اگر فقط شرکتهایی را بررسی کنید که هنوز فعالیت میکنند، ممکن است به این نتیجه برسید که یک استراتژی خاص همیشه موفق است؛ در حالی که شاید شرکتهای زیادی با همان استراتژی شکست خورده باشند و از نمونه بررسی شما حذف شده باشند.
این مسئله در Machine Learning هم اهمیت دارد. مدل از دادههایی یاد میگیرد که در اختیارش قرار میگیرند، نه از تمام واقعیت موجود. اگر دادههای آموزشی بهدلیل روش جمعآوری، فرایند برچسبگذاری یا قواعد انتخاب نمونهها دچار سوگیری باشند، مدل ممکن است الگوهایی را یاد بگیرد که در دنیای واقعی به همان شکل وجود ندارند.
برای مثال، اگر یک سیستم تشخیص تصویر فقط با نمونههای واضح و باکیفیت آموزش ببیند، عملکرد آن روی تصاویر تار، کمنور یا غیرمعمول ممکن است ضعیف باشد. این وضعیت بهخودیخود همیشه سوگیری بقا نیست؛ اما اگر نمونههای دشوار در فرایند جمعآوری یا ارزیابی حذف شوند و فقط نمونههای موفق باقی بمانند، احتمال ایجاد چنین سوگیریای وجود دارد.
نمونه اول؛ پرسشهایی که از دادههای جستوجو حذف شدند #
در سال 2022، Prashansa Gupta و Sean MacAvaney پژوهشی با عنوان On Survivorship Bias in MS MARCO منتشر کردند. این پژوهش به یکی از مجموعهدادههای شناختهشده در حوزه Information Retrieval، یعنی بازیابی اطلاعات، میپرداخت؛ حوزهای که در آن سیستمها تلاش میکنند اسناد مرتبط با یک پرسش را پیدا و رتبهبندی کنند.
در فرایند ساخت و ارزیابی مجموعهدادههای جستوجو، ممکن است برای بعضی پرسشها پاسخ مرتبطی پیدا نشود. اگر این پرسشها از مراحل بعدی آموزش یا ارزیابی کنار گذاشته شوند، مجموعه باقیمانده دیگر لزوماً نماینده همه پرسشهای اولیه نخواهد بود.
پژوهش Gupta و MacAvaney این مسئله را در MS MARCO بررسی کرد. نتایج گزارششده نشان میدادند که بخش قابل توجهی از پرسشها در فرایند اولیه پاسخ مناسبی دریافت نکرده بودند و حذف این موارد میتوانست بر ارزیابی سیستمهای بازیابی اطلاعات تأثیر بگذارد. بررسیهای بیشتر نیز نشان دادند که برخی از این پرسشها با روشهای بهتر بازیابی و رتبهبندی قابل پاسخدادن بودند.
چرا این موضوع مهم است؟ فرض کنید یک سیستم جستوجو را با مجموعهای ارزیابی کنید که بیشتر شامل پرسشهای ساده و دارای پاسخ مشخص است. چنین ارزیابیای ممکن است عملکرد سیستم را بهتر از چیزی نشان دهد که هنگام مواجهه با طیف واقعی پرسشها مشاهده میکنید.
در این حالت، مسئله فقط این نیست که مدل به بعضی پرسشها پاسخ نمیدهد؛ بلکه پرسشهایی که پاسخدادن به آنها دشوارتر است، ممکن است پیش از ارزیابی نهایی از مجموعه حذف شده باشند.
این پژوهش در آزمایشهای شبیهسازیشده نشان داد که مدلهای آموزشدیده با دادههای دارای سوگیری بیشتر، هنگام ارزیابی روی نسخههای کاملتر مجموعهداده میتوانستند تا 9.9 درصد عملکرد ضعیفتری داشته باشند. این عدد به شرایط آزمایش گزارششده مربوط است و نباید آن را به همه مدلهای جستوجو تعمیم داد.
این نمونه ارتباط مستقیمی با سوگیری بقا دارد: وقتی مواردی را که در مرحله اولیه موفق نبودهاند کنار میگذاریم، ممکن است عملکرد سیستم را بر اساس مجموعهای ناقص بسنجیم.
منبع: On Survivorship Bias in MS MARCO — arXiv
نمونه دوم؛ وقتی پیشبینی AI تشخیص پزشک را منحرف میکند #
نمونه دوم از حوزه پزشکی است، اما باید یک تفاوت مهم را در نظر گرفت: هر نوع سوگیری در خروجی AI، سوگیری بقا نیست. این مطالعه نشان میدهد که پیشبینیهای سوگیرانه چگونه میتوانند بر تصمیمگیری انسان تأثیر بگذارند و چرا کیفیت دادهها و نحوه استفاده از مدل اهمیت دارد.
در یک مطالعه منتشرشده در سال 2024 در مجله JAMA Network Open، پژوهشگران تأثیر پیشبینیهای AI بر تصمیمگیری تشخیصی پزشکان را بررسی کردند. در این آزمایش، 457 پزشک و متخصص درمانی سناریوهای تشخیصی مربوط به بیماریهای تنفسی را ارزیابی کردند.
نتایج نشان دادند که ارائه پیشبینیهای استاندارد AI میتوانست دقت تشخیص را بهبود دهد؛ اما وقتی مدل بهصورت نظاممند سوگیری داشت، دقت تشخیص پزشکان نسبت به سطح پایه 11.3 واحد درصد کاهش پیدا کرد.
برای مثال، یکی از مدلهای سوگیرانه احتمال ذاتالریه را برای بیماران بالای 80 سال بیش از حد تخمین میزد، حتی زمانی که علت واقعی مشکل تنفسی چیز دیگری بود. ارائه توضیحات تصویری مدل نیز نتوانست اثر منفی این پیشبینیهای سوگیرانه را بهطور معناداری برطرف کند.
این نتیجه یک نکته مهم درباره Human-AI Interaction را نشان میدهد: حتی متخصصان هم ممکن است تحت تأثیر خروجی یک سیستم هوشمند قرار بگیرند. در نتیجه، استفاده از AI لزوماً تصمیمگیری را بهتر نمیکند؛ کیفیت و نحوه ارائه پیشبینیها نیز اهمیت دارد.
ارتباط این مطالعه با سوگیری بقا غیرمستقیم است. اگر دادههای آموزشی یا فرایند انتخاب نمونهها نماینده مناسبی از گروههای مختلف بیماران نباشند، مدل ممکن است برای برخی گروهها پیشبینیهای نامناسبی تولید کند. البته برای اثبات سوگیری بقا باید مشخص شود که موارد حذفشده یا انتخابشده چگونه باعث این مشکل شدهاند؛ صرف مشاهده یک خروجی سوگیرانه برای چنین نتیجهای کافی نیست.
منبع: Measuring the Impact of AI in the Diagnosis of Hospitalized Patients — JAMA Network Open.
نمونه سوم؛ بیمارانی که مرگ آنها در دادهها دیده نمیشود #
یکی از چالشهای مهم در توسعه مدلهای پزشکی، کیفیت و کاملبودن پروندههای الکترونیکی بیماران است. این پروندهها منابع ارزشمندی برای آموزش و ارزیابی مدلها هستند، اما اطلاعات ثبتشده در آنها همیشه تمام رویدادهای مهم زندگی بیمار را منعکس نمیکنند.
در ژوئن 2026، پژوهشی با عنوان Invisible and Immortal: The Dead in Clinical-AI Data منتشر شد که نحوه ثبت اطلاعات مرگ بیماران را در دادههای پزشکی بررسی میکرد. پژوهشگر از مجموعهداده MIMIC-IV استفاده کرد؛ مجموعهدادهای که برای پژوهشهای مربوط به مراقبتهای ویژه و دادههای بالینی کاربرد دارد.
بر اساس گزارش این پژوهش، در 51.6 درصد از موارد مرگ بررسیشده، اطلاعات مربوط به مرگ را نمیشد تنها از دادههای بستری تشخیص داد و برای شناسایی آنها به پیوند با اطلاعات بیرونی نیاز بود. همچنین، در دادههای بررسیشده، اطلاعات مرگ در فیلدهای معمول تشخیص یا وضعیت بیماری ثبت نشده بود.
این مسئله برای مدلهای Clinical AI اهمیت زیادی دارد. فرض کنید مدلی برای پیشبینی پیامد درمان آموزش میدهید. اگر وضعیت نهایی بعضی بیماران بهدرستی ثبت نشده باشد، برچسبهای آموزشی ممکن است تصویر دقیقی از نتیجه واقعی درمان ارائه نکنند. در نتیجه، ارزیابی مدل نیز میتواند تحت تأثیر قرار بگیرد.
با این حال، باید بین دو مسئله تفاوت قائل شد: ثبتنشدن یک رویداد و حذف یک نمونه از مجموعهداده. اولی میتواند باعث ناقصشدن اطلاعات شود؛ دومی ممکن است مستقیماً به سوگیری انتخاب نمونهها منجر شود. این دو مسئله میتوانند با هم ارتباط داشته باشند، اما یکسان نیستند.
این پژوهش نمونهای از اهمیت دادههای ناقص در سیستمهای هوشمند پزشکی است. با توجه به اینکه مقاله هنگام انتشار یک پیشچاپ داورینشده بود، نتایج آن باید با احتیاط تفسیر شوند و بهتر است پیش از استفاده از آن بهعنوان مبنای یک تصمیم مهم، وضعیت انتشار نهایی و روششناسی پژوهش بررسی شود.
منبع: Invisible and Immortal: The Dead in Clinical-AI Data — Cambridge Open Engage.
چگونه اثر سوگیری بقا را کاهش دهیم؟ #
حذف دادهها همیشه اشتباه نیست. گاهی نمونهها بهدلیل خرابی، اطلاعات نامعتبر، نقض معیارهای پژوهش یا مشکلات کیفیت باید کنار گذاشته شوند. مشکل زمانی ایجاد میشود که این حذفها بدون بررسی اثرشان بر ترکیب دادهها انجام شوند.
برای کاهش این خطر، چند اقدام عملی میتواند مفید باشد:
- ثبت فرایند حذف دادهها: مشخص کنید چه نمونههایی، با چه معیاری و در کدام مرحله حذف شدهاند.
- مقایسه دادههای اولیه و نهایی: بررسی کنید که توزیع گروهها، ویژگیها و انواع پرسشها پس از پاکسازی چه تغییری کرده است.
- بررسی نمونههای ناموفق: پرسشهایی که پاسخ مناسبی دریافت نکردهاند یا نمونههایی که مدل در آنها شکست خورده است، ممکن است اطلاعات مهمی درباره محدودیتهای سیستم داشته باشند.
- ارزیابی روی دادههای متنوع: عملکرد مدل را فقط روی نمونههای ساده یا موفق نسنجید. شرایط دشوار و گروههای مختلف را نیز در نظر بگیرید.
- تفکیک دادههای ناقص از دادههای نامعتبر: نبود یک مقدار لزوماً به معنی بیارزشبودن کل نمونه نیست. گاهی میتوان با روشهای مناسب، داده را حفظ کرد و عدم قطعیت را در تحلیل در نظر گرفت.
یک بررسی ساده برای پروژههای Machine Learning
قبل از حذف نمونههای ناقص، تعداد و ویژگیهای آنها را با نمونههای باقیمانده مقایسه کنید. اگر نمونههای حذفشده بهطور معناداری با نمونههای باقیمانده تفاوت داشته باشند، باید بررسی کنید که این تفاوت چگونه میتواند بر آموزش یا ارزیابی مدل اثر بگذارد.
برای مثال، در یک پروژه طبقهبندی، میتوانید توزیع کلاسها را قبل و بعد از پاکسازی دادهها بررسی کنید. اگر درصد یک کلاس پس از حذف نمونهها بهشدت تغییر کرده باشد، باید دلیل این تغییر را مشخص کنید و بررسی کنید که آیا معیارهای ارزیابی هنوز با هدف واقعی پروژه سازگار هستند یا خیر.
نکته مهم این است که صرف حفظ تمام دادهها نیز راهحل مناسبی نیست. دادههای تکراری، برچسبهای اشتباه و اطلاعات نامعتبر ممکن است کیفیت مدل را کاهش دهند. هدف، جلوگیری از حذف بیدلیل اطلاعات مهم و درک تأثیر تصمیمهای مربوط به آمادهسازی دادههاست.
تفاوت سوگیری بقا با سایر سوگیریها #
سوگیری بقا یکی از انواع مشکلاتی است که میتواند در دادههای مورد استفاده برای توسعه مدلهای هوش مصنوعی رخ دهد. شناخت تفاوت آن با مفاهیم نزدیک کمک میکند علت یک مشکل را دقیقتر تشخیص دهید.
| نوع سوگیری | توضیح | مثال |
|---|---|---|
| Survivorship Bias | تمرکز بر موارد باقیمانده و نادیدهگرفتن موارد حذفشده | ارزیابی شرکتها بدون بررسی شرکتهای شکستخورده |
| Selection Bias | انتخاب نمونههایی که نماینده مناسبی از جامعه هدف نیستند | جمعآوری داده فقط از یک گروه خاص |
| Sampling Bias | نامتوازن یا نامناسببودن روش نمونهگیری | نمونهگیری بیش از حد از یک گروه جمعیتی |
| Label Bias | وابستگی برچسبها به قضاوتها یا فرایندهای سوگیرانه | برچسبگذاری نامتوازن تصاویر توسط ارزیابها |
| Missing Data | ثبتنشدن بعضی مقادیر یا اطلاعات | نبود نتیجه نهایی درمان در پرونده بیمار |
این مفاهیم میتوانند همزمان در یک پروژه وجود داشته باشند. برای مثال، اگر پروندههای ناقص بیماران بهصورت نامتوازن از مجموعهداده حذف شوند، مسئله Missing Data میتواند به Selection Bias و در شرایط مناسب به Survivorship Bias منجر شود.
بنابراین، برای نامگذاری دقیق یک مشکل باید به فرایند تولید، انتخاب و حذف دادهها توجه کنید؛ نه اینکه صرفاً هر نتیجه نادرست مدل را به یک نوع سوگیری نسبت دهید.
جمعبندی #
سوگیری بقا در هوش مصنوعی یادآوری میکند که کیفیت یک مدل فقط به الگوریتم یا دادههایی که باقی ماندهاند وابسته نیست؛ دادههایی که حذف شدهاند نیز ممکن است برای فهم عملکرد واقعی سیستم اهمیت داشته باشند. پژوهشهای حوزه جستوجوی هوشمند و پزشکی نشان میدهند که حذف نمونهها، ناقصبودن اطلاعات و استفاده از پیشبینیهای سوگیرانه میتوانند بر نتیجهگیریها تأثیر بگذارند، هرچند همه این مشکلات را نباید مستقیماً سوگیری بقا نامید.
هنگام ساخت مدل بعدی خود، علاوه بر پرسیدن اینکه مدل چه پاسخهایی را درست پیشبینی میکند، بررسی کنید چه نمونههایی از دادهها کنار گذاشته شدهاند، چرا حذف شدهاند و آیا دادههای باقیمانده نماینده مناسبی از مسئله واقعی هستند یا خیر.
سوالات متداول #
آیا سوگیری بقا فقط در هوش مصنوعی رخ میدهد؟
خیر. این مفهوم در آمار، اقتصاد، علوم اجتماعی، پزشکی و تحلیل کسبوکار نیز کاربرد دارد. هر جا که بررسی فقط بر موارد باقیمانده یا قابل مشاهده متمرکز شود، احتمال سوگیری بقا وجود دارد.
آیا حذف دادههای ناقص همیشه باعث سوگیری بقا میشود؟
خیر. حذف دادههای ناقص ممکن است در بعضی شرایط ضروری باشد. زمانی خطر سوگیری افزایش پیدا میکند که احتمال حذف نمونهها به ویژگیهای مهم آنها وابسته باشد و نمونههای باقیمانده دیگر نماینده مناسبی از جامعه هدف نباشند.
تفاوت Survivorship Bias و Selection Bias چیست؟
Selection Bias مفهوم گستردهتری است و به سوگیری ناشی از انتخاب نمونهها اشاره میکند. Survivorship Bias زمانی رخ میدهد که تمرکز بر موارد باقیمانده باعث نادیدهگرفتن موارد حذفشده یا ناموفق شود و این وضعیت میتواند یکی از شکلهای Selection Bias باشد.
چگونه سوگیری بقا را در یک پروژه Machine Learning تشخیص دهیم؟
فرایند جمعآوری و پاکسازی دادهها را بررسی کنید، ویژگیهای نمونههای حذفشده را با نمونههای باقیمانده مقایسه کنید و عملکرد مدل را در گروهها و شرایط مختلف بسنجید. اگر اطلاعات نمونههای حذفشده در دسترس نیست، تشخیص قطعی علت سوگیری ممکن است امکانپذیر نباشد.
آیا افزایش حجم دادهها مشکل سوگیری بقا را حل میکند؟
نه لزوماً. اگر دادههای بیشتر با همان روش سوگیرانه جمعآوری شوند، حجم بالاتر بهتنهایی مشکل را برطرف نمیکند. نمایندگی دادهها، کیفیت برچسبها و فرایند انتخاب نمونهها به اندازه حجم داده اهمیت دارند.